Por qué muchos chatbots de IA cuestan cinco veces más de lo que deberían
En resumen
- Cerca del 98 % de lo que se paga en cada respuesta de un agente de IA es releer las mismas instrucciones del negocio, no la pregunta del cliente.
- La caché de prompt guarda esa parte fija y la relee a una fracción del precio, sin cambiar la respuesta.
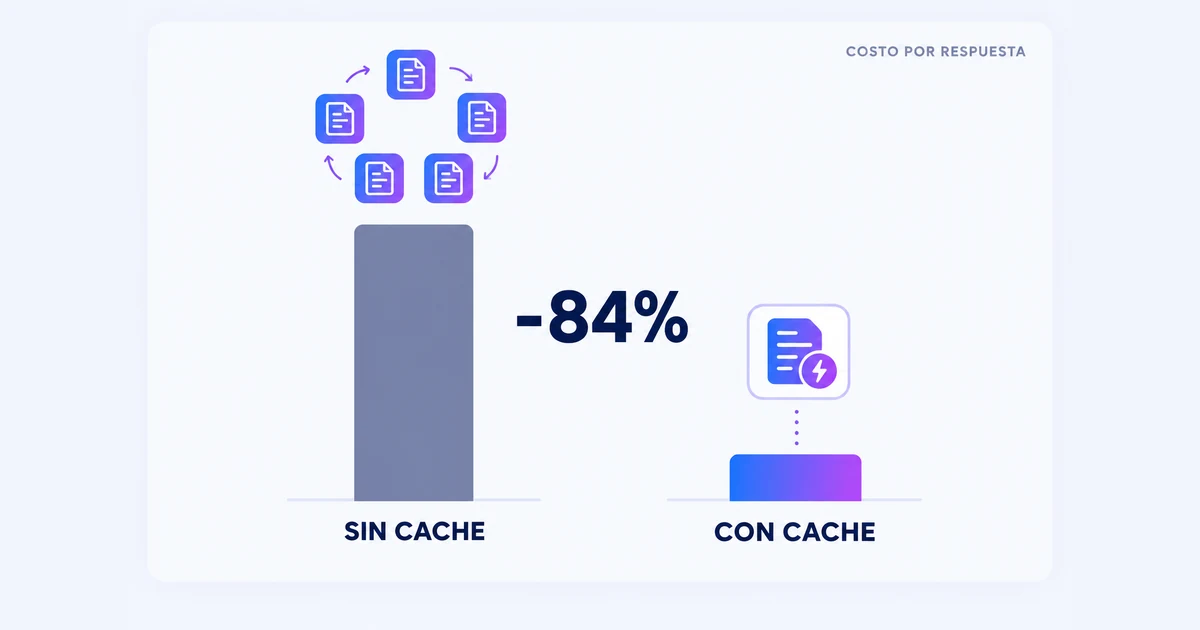
- En nuestro agente en producción, el ahorro medido fue del 84 % por respuesta.
- Antes de contratar, pregunta si usan caché de prompt y qué porcentaje de los tokens se reutiliza: un dato que cambia en el guion, como la fecha, la rompe sin que nadie lo note.
Si estás comparando propuestas de chatbots con inteligencia artificial, probablemente te fijas en la mensualidad. Es lo lógico. Pero hay un detalle técnico que casi nadie menciona en una reunión comercial y que, según cómo esté resuelto, hace que el mismo servicio cueste cinco veces más o cinco veces menos.
No tiene que ver con cuánto habla el agente. Tiene que ver con cuánto relee cada vez que responde.
El problema: el 98% de lo que se paga es releer lo mismo
Un agente de IA no recuerda nada por sí solo entre un mensaje y el siguiente. Cada vez que alguien escribe, el sistema le vuelve a entregar al modelo el paquete completo: las reglas de comportamiento, el guion del negocio, qué vende, a qué precios, qué puede y qué no puede decir, cómo calificar a un interesado.
En un agente bien construido ese paquete son unas 6.000 unidades de texto — se llaman tokens, y son la unidad con la que se factura la inteligencia artificial. Lo que aporta la persona del otro lado, su pregunta, son unas 100.
Haz la cuenta: alrededor del 98% de lo que se paga en cada respuesta es releer un texto que no ha cambiado.
Es como si en cada mensaje le entregaras a un asesor nuevo la carpeta completa del negocio para que se la lea entera, y solo al final le dijeras la pregunta del cliente. Te cobra la lectura de la carpeta cada vez.
Y una conversación completa — saludo, cuatro preguntas de calificación, dudas y propuesta de cita — son unas quince respuestas. Quince lecturas de la misma carpeta.
La solución: la caché de prompt
Existe desde hace un tiempo y se llama caché de prompt. La idea es simple: se le indica al modelo que ese bloque de texto es siempre el mismo y que lo guarde en memoria.
La primera llamada cuesta un poco más, porque además de leer tiene que guardar. Las siguientes releen ese bloque a la décima parte del precio.
La respuesta que recibe el cliente final es exactamente la misma. No cambia una palabra. Lo único que cambia es la factura.
El dato: 84% menos por respuesta
No lo calculamos en una hoja de cálculo. Lo medimos llamada por llamada contra nuestro agente en producción, el que hoy atiende a un cliente real.
El ahorro medido fue del 84% por respuesta.
Dicho de otro modo: el mismo agente, dando las mismas respuestas, con la misma calidad, por una fracción del costo. Ese ahorro es la razón por la que podemos ofrecer planes desde $99.000 COP al mes en un mercado donde lo normal arranca cerca de los $390.000.
La letra pequeña que casi nadie cuenta
Aquí viene la parte incómoda, y es la que más vale la pena que sepas si vas a contratar a alguien.
El bloque guardado dura unos minutos sin uso. Si pasa ese tiempo, se descarta y la siguiente respuesta vuelve a pagar precio completo. En un negocio con conversaciones espaciadas, eso es normal y no hay mucho que hacer.
Pero hay algo peor. Si dentro del guion metes algo que cambia siempre — la fecha, la hora, un saludo con el nombre de la persona, un número aleatorio — el bloque deja de ser idéntico y la caché deja de aplicarse por completo.
Y nadie te avisa. No sale un error, no hay una alerta, el agente responde igual de bien. Simplemente pagas cinco veces más, mes tras mes, sin enterarte.
Por eso en nuestra implementación medimos, en cada respuesta, cuántas unidades de texto se reutilizaron de la caché. Si ese número cae, sabemos que algo se rompió en el guion antes de que se note en la factura.
Qué preguntarle a tu proveedor actual
Si ya tienes un chatbot con IA funcionando, o estás por firmar con alguien, son dos preguntas:
- ¿Usan caché de prompt?
- ¿Qué porcentaje de mis tokens se está reutilizando?
Si la respuesta a la primera es que sí pero no saben responder la segunda, la caché puede estar rota sin que nadie lo haya notado. Y si no saben de qué les estás hablando, es muy probable que estés pagando de más.
No lo decimos para incomodar a nadie. Lo decimos porque es la clase de detalle que separa a quien armó un agente de verdad de quien conectó dos herramientas y le puso precio.
Cómo lo hacemos en IANALITICS
Nuestro Agente IA de WhatsApp usa caché de prompt desde el primer día, con el guion estructurado a propósito para que la parte fija se mantenga fija. También filtramos por código — sin gastar inteligencia artificial — el spam y los mensajes que no son del negocio, y el sistema tiene topes de gasto diarios y mensuales para que nadie pueda disparar el consumo escribiendo sin parar.
Puedes ver lo que incluye cada plan y simular tu costo en la página de precios, o escribirnos por WhatsApp y hablar directamente con nuestro propio agente: es la mejor demostración que te podemos dar.
¿Te sirvió? Cada semana compartimos guías como esta en LinkedIn. Sigue a IANALITICS en LinkedIn →